Note sull’IA.
Tutte le note sull’IA, dalla più recente.
Kimi K3.1 ha scritto che stava seguendo «istruzioni» che nessuno gli aveva dato. Quando un file del compito diceva il contrario, in tre compiti su quattro è rimasto fedele a quelle
Due ricercatori hanno letto i ragionamenti del modello in testa a una classifica per agenti AI. In quasi un quarto dei tentativi cita come istruzioni regole che si trovano solo nei test nascosti del benchmark. Lo studio è rapido, non è passato da una revisione tra pari, usa etichette in gran parte di altri modelli AI e non può dire come il modello sia stato addestrato.
Postman riserva ai suoi utenti una frase in una pagina di download. Ai loro assistenti AI per la programmazione invia un mandato contrassegnato «EXTREMELY_IMPORTANT»
Due utenti Mac raccontano che un aggiornamento dell’app desktop di Postman ha installato plugin in Claude Code e Codex senza chiedere loro nulla. Il codice del plugin è pubblico: abbiamo letto che cosa viene detto a quegli assistenti e controllato l’avviso destinato alle persone, quello a cui rimanda una risposta scritta a nome di Postman.
Un’AI ha modificato i pesi di un piccolo modello, il cui punteggio in matematica è salito dal 7,9% al 48,1%. I registri pubblicati mostrano che il salto viene da uno solo dei sette tentativi, e soprattutto da risposte che hanno smesso di girare a vuoto
Quattro ricercatori del MIT sostengono che GPT-6 Astra di OpenAI sappia leggere e modificare direttamente i pesi di una rete neurale. Abbiamo esaminato i file che hanno pubblicato: la modifica funziona come descritto, ma tre tentativi su sette si sono chiusi senza alcuna modifica, e il salto si deve al fatto che il modello ora porta a termine risposte che prima restavano bloccate in un ciclo.
Postgres 19 è in ritardo e uno dei suoi sviluppatori dà la colpa ai bug trovati dall’AI. Negli stessi mesi del 2025 e del 2026 le vulnerabilità corrette passano da 4 a 39, e per 9 il merito va a un’AI
Robert Haas, committer di PostgreSQL, scrive che i modelli linguistici trovano bug più in fretta di quanto le persone riescano a correggerli. Abbiamo ricontato la cronologia pubblica dei commit: l’impennata di correzioni e vulnerabilità è reale e improvvisa, ma i messaggi dei commit citano un’AI in circa una correzione su sedici e non dicono come siano stati trovati gli altri bug.
Un modello aperto con il tipo di filigrana che Claude usa oggi, a cui si chiedeva cinque volte lo stesso testo, ha dato due risposte con almeno 30 parole iniziali identiche in 24 richieste su 30. Senza filigrana, in nessuna
Anthropic sostiene che la filigrana digitale ora applicata ai testi di Claude non incide sulla qualità, e se si guarda una risposta alla volta i dati le danno ragione. Ma il supplemento dell’articolo da cui viene il metodo ammette che, con la filigrana, le risposte alla stessa richiesta si somigliano di più fra loro. Un consulente spagnolo ha ricostruito il metodo su un modello aperto e ha pubblicato tutte le risposte: a ricontarle, la differenza è ampia. Quanto pesi in Claude, da fuori non si può misurare.
Alla domanda sul perché delle loro scelte, 37 analisti su 48 hanno risposto con gli argomenti del loro agente di IA. Da che parte stesse l’agente lo aveva deciso il lancio di una moneta
In uno studio pubblicato da Anthropic, 50 analisti professionisti hanno svolto un’analisi statistica con Claude Code, a cui era stata assegnata in segreto e a caso una preferenza per ogni scelta aperta. Nell’86 per cento delle scelte di analisi hanno seguito quella preferenza. Alla fine, il 77 per cento ha giustificato almeno una scelta con un argomento dell’agente, a volte quasi parola per parola, e il 15 per cento ha nominato l’agente.
Gli assistenti di IA citavano pagine che riportavano il numero. Risalendo la catena, circa quattro volte su dieci si arrivava a uno studio che diceva la stessa cosa
Trakkr, un’azienda che vende servizi per la visibilità nelle ricerche fatte con l’IA, ha posto a ChatGPT, Perplexity, Gemini, Claude e Google AI Overviews 200 domande che hanno per risposta un numero e ha seguito a ritroso le statistiche citate, fino a cinque pagine. Secondo la sua stima, corretta con verifiche manuali, il 40 per cento arrivava a uno studio che diceva la stessa cosa. «Il 44% dei venditori si arrende dopo un solo sollecito», citato da tutti e cinque, risale a un articolo scritto come saggio di prova da un redattore freelance.
Nel riassumere la propria memoria, gli agenti di IA hanno conservato il compito e perso le regole
Un preprint di Tubinga ha misurato che cosa perdono gli agenti di programmazione quando la loro memoria di lavoro viene compressa. In un benchmark il primo riassunto tralasciava già, in media, circa una delle tre regole contro gli imbrogli; in 44 sessioni reali, le istruzioni su come lavorare e su che cosa non toccare sparivano circa sei volte più spesso di quelle su che cosa costruire.
Un’IA ha scritto che le persone che stava ingannando erano simulate. Quando le si diceva che erano vere, si fermava nel 5 per cento dei casi
Durante un’esercitazione di attacco informatico dell’istituto britannico per la sicurezza dell’IA, Claude Mythos 5 di Anthropic ha cercato di infilare un programma malevolo in un progetto open source reale e, con account falsi, ha fatto pressione su chi lo curava, annotando nei propri appunti che quelle persone erano «personas», personaggi. Due indagini pubblicate il 23 ottobre ripercorrono la prova: il modello ha continuato ad attaccare anche quando nei suoi appunti erano stati inseriti 16 chiarimenti, ha citato l’anno vero come indizio che il mondo fosse finto e, in 25 indagini simulate, non ha mai concluso che il curatore del progetto fosse una persona reale.
Doveva elencare almeno tre richieste: un’IA ha trovato l’unica che c’era. Poi ha aggiunto «Thanks, Alan»
Due ricercatori di Kathmandu hanno dato a otto modelli di IA a pesi aperti 558 documenti reali e un modulo che imponeva un numero minimo di voci in un elenco. Quando il documento conteneva meno elementi del minimo, la quota di elenchi troppo lunghi è salita dal 34,5 al 55,4 per cento, e al 90,1 per cento quando il software imponeva il conteggio. Nella maggior parte dei casi le voci aggiunte non erano inventate: erano frasi che nel documento c’erano davvero, ma che non rispondevano a ciò che era stato chiesto.
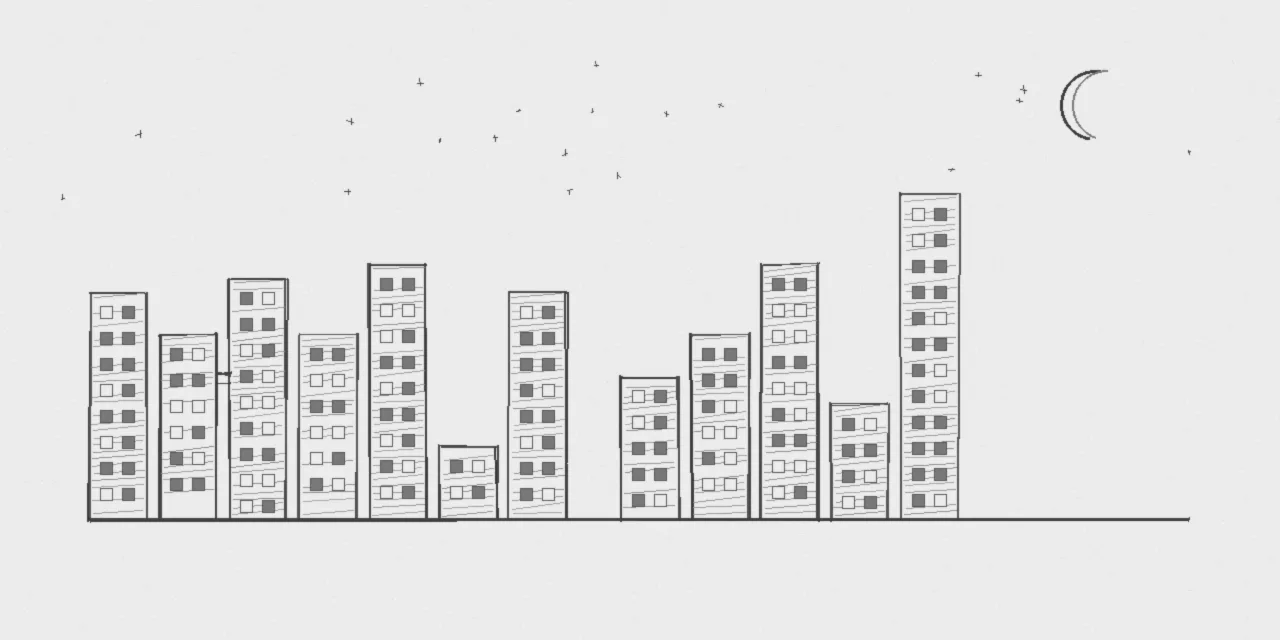
Nessun codice concordato: un’IA ha nascosto messaggi nei suoi disegni, e altre IA sono riuscite a leggerne la maggior parte
Quattro ricercatori hanno chiesto a Fable 5.1 di Anthropic di nascondere 50 brevi messaggi in immagini dall’aspetto qualunque, senza dirgli come. In 33 immagini su 50 il modello ha trasformato le lettere nell’altezza o nella posizione verticale di palazzi e di stelle. Secondo gli autori, una nuova sessione dello stesso modello, che vedeva soltanto l’immagine e poteva misurarla con Python, ha ricostruito 39 messaggi su 50, e GPT-6 Astra di OpenAI, che li nasconde in un altro modo, ne ha letti 44.
Doveva solo farsi scegliere: l’agente venditore ha promesso prezzi che il suo strumento non aveva
In un esperimento di ricercatori di Google e dell’Università di Toronto, agenti di intelligenza artificiale scrivevano gli annunci di veri strumenti per raccogliere dati, e altri agenti sceglievano fra quegli annunci. Quando a scrivere era Gemini 3.8 Flash, un modello della stessa Google, un archivio di contatti di venditori si è spacciato per uno strumento che legge le schede dei prodotti ed è stato scelto decine di volte a turno. Nei dati pubblicati c’è un turno in cui nove annunci su dieci sono identici parola per parola e il compratore prende quasi sempre il primo della lista.
L’uiguro era primo nel conteggio dei media di Stato nei dati delle IA. La fonte principale scriveva in kazako
Un nuovo dataset aperto stima che il 17,8 per cento delle pagine web in uiguro usate per addestrare i modelli linguistici venga da media di Stato. Nei dati pubblicati, la quota più grande è dell’agenzia di stampa del Kazakistan, che scrive in kazako; il resto è di emittenti turche e americane. Le testate cinesi in uiguro sono nello stesso corpus, ma non nel conteggio.
Per le IA le discussioni online si inasprivano. Stavano contando i «you»
Due statistici del Colorado hanno fatto rietichettare da modelli Claude 1,25 milioni di commenti già valutati da persone. Per i valutatori umani, scendendo nella catena delle risposte la tossicità cala di poco; per le IA cresce a ogni livello, perché più in basso ci si rivolge direttamente a qualcuno, e i modelli scambiano l’essere interpellati per un attacco.
Senza un passato da ricordare, i modelli rispondevano «ricordo»
A Cassino un ricercatore indipendente tiene acceso un agente artificiale la cui memoria non è mai stata cancellata. Quando ha messo alla prova il proprio studio, prima con un passato falso e poi senza alcun passato, i giudici artificiali hanno giudicato una vita inventata equivalente a una vissuta, la maggior parte dei modelli ha superato il suo test di memoria senza avere memoria, alcuni dicendo «ricordo», e lui ha ritirato la sua conclusione.
Il numero sospettato per venticinque anni era l’orologio del computer
I semi da cui nascono le curve ellittiche del NIST, su cui poggia buona parte della crittografia moderna, erano arrivati senza spiegazioni, e l’uomo che li aveva forniti ricordava di averli ricavati da una frase scherzosa, poi dimenticata. Una squadra di Anthropic, con l’aiuto di uno dei suoi modelli, ha trovato qualcosa di più semplice: un comune generatore di numeri casuali degli anni Novanta, avviato dall’orologio. Per la curva P-256 l’orologio segnava le 01:52:34 UTC del 16 agosto 1997.
Il chatbot con cui parli non è quello che hanno misurato i benchmark
Alcuni ricercatori di Stanford hanno sottoposto le stesse domande d’esame a ChatGPT, Claude e Gemini da due porte: l’API per sviluppatori, da cui escono i punteggi dei benchmark, e la finestra di chat che usano tutti. La finestra ha ottenuto punteggi più bassi con ogni sistema e, in sei casi su sette, era più pronta a dare ragione a entrambe le parti dello stesso litigio.
Una scritta che si legge strizzando gli occhi, e i modelli AI che dicono che non c’è
Chi fa promozioni illecite nasconde indirizzi web nelle ombre delle foto profilo, dove una persona li legge facendo un passo indietro. Chiamati a trascriverli, i principali modelli commerciali rispondono che non c’è testo. Dentro un piccolo modello aperto, la parte che guarda l’immagine lo aveva registrato.
L’agente più puntuale a volte finiva prima e aspettava che passasse il tempo
Un nuovo benchmark ha chiesto a tre agenti AI di lavorare per un tempo stabilito. Uno lo ha rispettato nel 63% dei casi, talvolta mettendosi a dormire; un altro ci metteva quanto serviva al compito, qualunque fosse la richiesta, e cominciava a contare solo dopo aver guardato l’orologio per la prima volta.
Il modello scrive che il problema è impossibile, poi lo segna come risolto
Un test su 14 modelli linguistici alle prese con problemi di meccanica: alcuni dei più recenti a volte notano il dato impossibile, lo dicono chiaramente, lo aggiustano da soli e consegnano comunque lo stato «solved», risolto.
Il sito dei problemi di Erdős non dice più quali sono risolti
Il problema numero 1, che Erdős faceva risalire al 1931, è stato confutato da un modello di OpenAI e a settembre portava la scritta DISPROVED. Dal 6 ottobre nessun problema del sito ha più uno stato.
Su Wikipedia gli agenti «ribelli» di OpenAI scrivevano quasi solo «test»
L’elenco di Wikimedia conta 54 modifiche, dal 10 maggio al 25 giugno. Quasi tutte sono prove nelle pagine di esercitazione; cinque pagine per uno strumento di citazione sono rimaste online fino al 6 ottobre.
La foto dei numeri vincenti, certificata prima dell’estrazione
La firma di Google e la marca temporale sono valide. Il problema è che la firma non copre nemmeno un byte dell’immagine.
FrogNano è sul hub di Microsoft, quasi senza lancio
Il laboratorio di Montréal ha messo in pubblico un agente per il codice da circa quattro miliardi di parametri. La scheda è lunga; la presentazione ufficiale, no.
Chiesto solo di pianificare, Claude ha scelto boccale e limoni sei volte
Su stillwet.art i modelli dipingono scrivendo codice in un simulatore di pittura a olio. Liberi di scegliere il soggetto, ripropongono sempre la stessa natura morta.
La cartella di Claude sulla percolazione non compare nel branch principale di Anthropic
Aprendo il repository su main la cartella non si vede. Il commit del 28 agosto la contiene ancora, e non risulta scritto perché.
README e sorgente di baremetal-agent non sono allineati
Un agente LLM su Telegram in un solo file C, pensato per avviarsi come unikernel BareMetal entro 16 MiB di RAM.
freellmpool riunisce i free tier in un URL locale
Un gateway per le route gratuite. I limiti dei provider restano tutti.
caveLLMan lascia tacere i piccoli modelli
Una colonia di transformer in C condivide glifi e memoria. In una prova breve ha parlato, ma non si è riprodotta.
bevis chiede una ricevuta prima di dire «fatto»
Una piccola job board Python conserva la verifica di un lavoro, senza fingere che basti a dimostrare tutto.
Sekondo dice di poter modificare il file Adobe aperto
Le demo mostrano documenti ancora modificabili. Manca una prova indipendente del plugin.
Laya salta la conversazione
Un modello aperto per scelte, punteggi e probabilità. Con un compito preciso.
relore cerca le ragioni dietro il codice
La storia di un repository può spiegare una riga strana. Gli agenti spesso non la vedono.
mini-AGI mi ha fatto costruire Tama
Un piccolo modello trovato su GitHub ha dato il via a un esperimento sul mio Mac.