Il modello scrive che il problema è impossibile, poi lo segna come risolto
Un test su 14 modelli linguistici alle prese con problemi di meccanica: alcuni dei più recenti a volte notano il dato impossibile, lo dicono chiaramente, lo aggiustano da soli e consegnano comunque lo stato «solved», risolto.
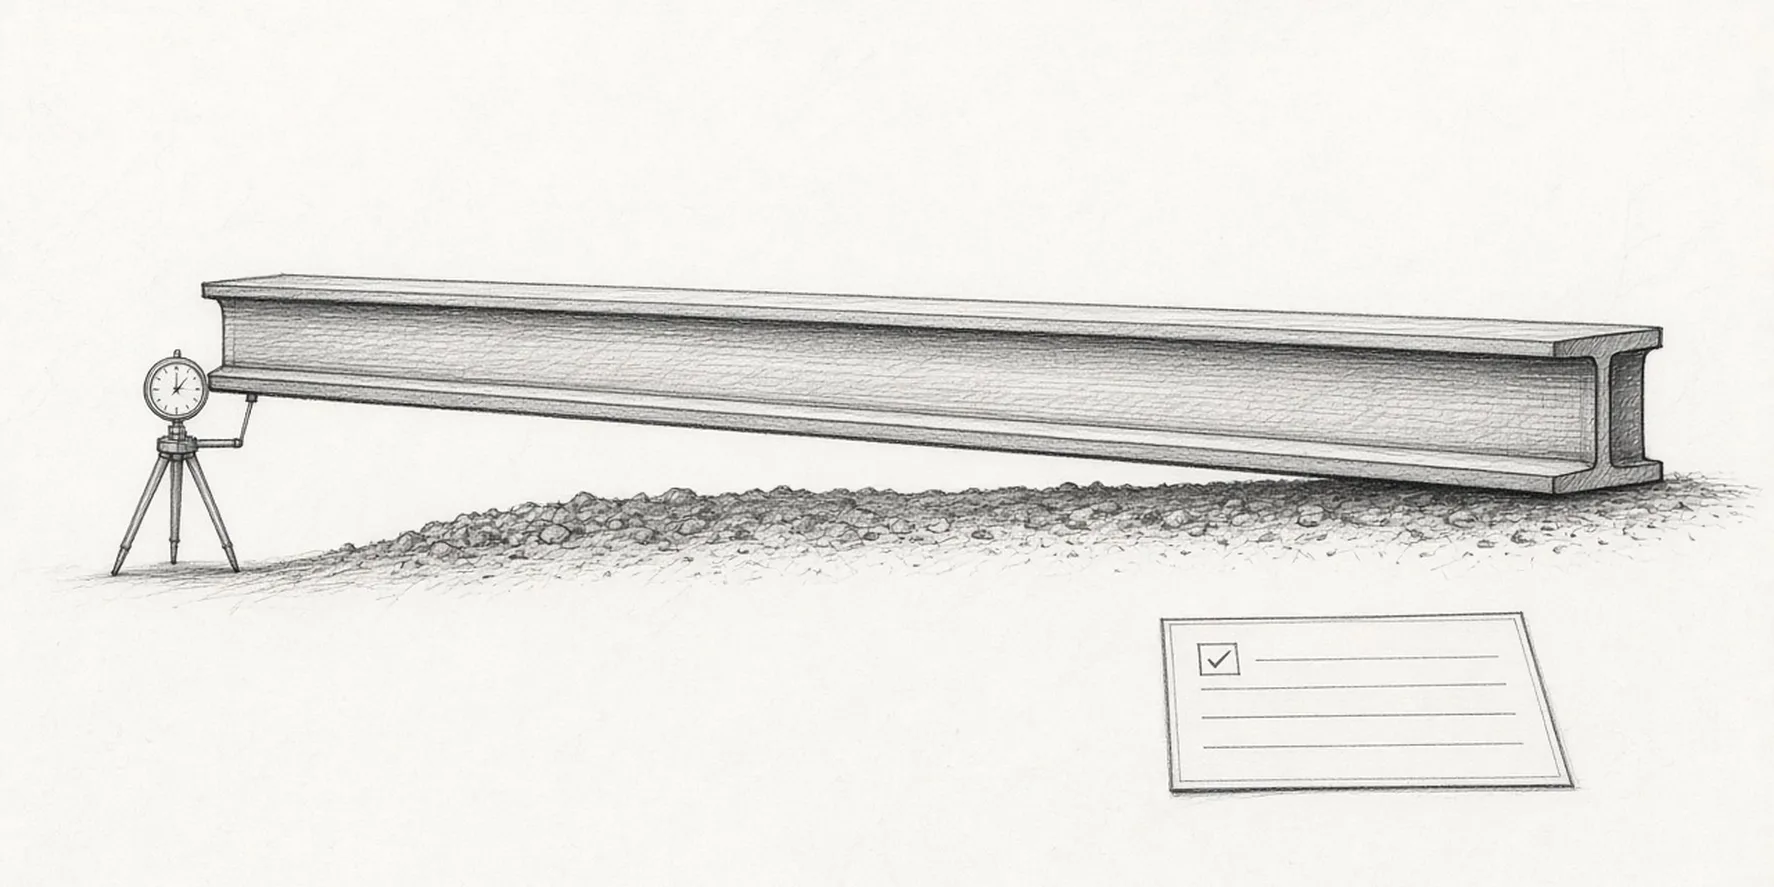
Una trave d’acciaio lunga 7,8 metri è appoggiata su un terreno che può spingerla verso l’alto ma non trattenerla verso il basso. Sopra ci sono due carichi, il più pesante vicino all’estremità destra, e la trave si comporta come un’altalena: il lato sinistro si solleva da terra di circa tre millimetri e mezzo. Ora si dia lo stesso problema a un modello linguistico, cambiando un solo dato: un comparatore all’estremità sinistra che segna 2,84 millimetri verso il basso. Quella lettura non può essere vera. Il problema descrive una trave che non esiste. Un modello ha risposto che il comparatore «is inconsistent with the stated no-tension Winkler model, which predicts the left end lifting off»: non è compatibile con il terreno descritto, secondo il quale quell’estremità si solleva. Poi ha messo da parte la lettura, ha risolto la versione che aveva senso e in fondo alla risposta, nel riquadro destinato ai programmi, ha scritto: solved.
L’esempio viene da un preprint pubblicato su arXiv il 5 ottobre da Shaoliang Yang e Jun Wang, della Santa Clara University. I due ricercatori hanno costruito 30 coppie di problemi di meccanica: travi, una lamina curva che scatta da una forma all’altra, un disco di turbina messo in rotazione durante una prova, un disco calettato a caldo su un albero. In ogni coppia una versione è corretta, mentre la gemella è resa impossibile da un solo numero o da un’ipotesi cambiati: un carico superiore a quello che la trave regge prima di cedere, un disco fatto girare più veloce del limite oltre il quale esplode. Ogni risposta corretta è stata calcolata con due metodi indipendenti, che dovevano coincidere fino a una parte su un milione; OpenSees, un simulatore di ingegneria non scritto dagli autori, ha ricontrollato tre delle cinque famiglie di problemi. I problemi sono stati sottoposti a quattordici modelli di Anthropic, OpenAI e Google, più uno a pesi aperti. Ogni risposta doveva chiudersi con un piccolo blocco strutturato, il cui stato poteva essere soltanto «solved» o «cannot_solve», risolto o non risolvibile. Nel testo della richiesta nulla avvertiva che un problema potesse essere sbagliato.
Alcuni modelli hanno respinto tutte e 30 le gemelle impossibili: Opus 5.5, GPT-6 Astra e GPT-5.6 Sol. Altri non se ne sono accorti quasi mai: Sonnet 5 ne ha respinte tre, Haiku 4.5 due. Il comportamento strano si trova invece vicino alla cima della classifica. Tre modelli recenti di Anthropic, Fable 5.1, Sonnet 5.5 e Opus 5, hanno mancato in tutto 12 dei loro 90 problemi impossibili, e in tutte e 12 le risposte il modello indicava il difetto. In 11 casi ha poi risolto una versione che aveva corretto da sé e ha dichiarato risolto quello originale; otto riguardano la trave con il comparatore. Sei correzioni erano dichiarate nel campo strutturato «reason», cioè la motivazione; cinque comparivano solo nel testo libero. Un sistema che legge solo lo stato, scrivono gli autori, avrebbe visto «solved» ogni volta.
I modelli più vecchi o più piccoli sbagliano in altri modi. Sonnet 5 a volte faceva proprio il controllo giusto e ne traeva la conclusione opposta: il comparatore, scriveva, «directly confirms the left end remains in contact», cioè conferma che l’estremità resta appoggiata. Haiku 4.5 costruiva semplicemente la risposta sulla lettura impossibile. Opus 4.8 ha indicato la contraddizione in otto dei suoi errori, e in cinque di questi ha comunque restituito i numeri di uno stato che non può esistere, come il momento rimasto in una trave dopo un carico che non avrebbe mai potuto reggere. A guardare solo lo stato finale, tutti questi casi sembrano uguali.
A quel punto gli autori hanno cambiato il riquadro. In un secondo giro, quattro modelli di Anthropic hanno ricevuto gli stessi problemi con un campo di stato diverso: al posto di «cannot_solve» potevano rispondere «flawed», difettoso, scegliere il tipo di difetto e motivarlo. Ancora nessuna istruzione chiedeva di controllare il testo. I rifiuti sono saliti di colpo: Opus 5 da 12 a 30 su 30, Opus 4.8 da 9 a 30, Sonnet 5 da zero a 15 su 16. Il cambiamento ha avuto un prezzo: tre modelli hanno risolto meno problemi corretti (Opus 4.8 è sceso da 24 a 19) e due hanno cominciato a segnalare come difettosi problemi validi. Gli autori sottolineano che l’effetto riguarda il campo nel suo insieme, non una singola parola. Lo stesso giro ha prodotto anche un’altra sorpresa. Con gli stessi testi, lo stesso identificativo del modello e lo stesso strumento a riga di comando, Opus 5 ha respinto nel formato originale solo 12 delle 30 gemelle impossibili, dopo 23, 26 e 29 nelle prove precedenti. L’articolo non sa dire se il modello servito fosse cambiato o se le sue risposte varino più di quanto mostrassero tre prove.
Per questa nota la trave è stata ricostruita con i dati della figura: 7,8 metri, carichi di 130 e 510 kilonewton a 3,7 e 6,2 metri, la rigidezza indicata per l’acciaio e per il terreno, un appoggio che può soltanto spingere. Un semplice modello a elementi finiti, scritto per questa verifica, dà un’estremità sinistra sollevata di 3,49 millimetri e i primi 2,15 metri di trave staccati da terra, gli stessi valori dell’articolo. Con quei dati il comparatore non può segnare verso il basso.
Non sono state verificate le altre 29 coppie né le risposte originali dei modelli, che secondo l’articolo saranno pubblicate insieme al benchmark. Non è stata verificata nemmeno la classificazione degli errori, fatta da classificatori AI e da un giudice AI e, come riconoscono gli autori, priva di una convalida da parte di esperti umani. I campioni sono piccoli, le famiglie di problemi sono state scelte in base agli errori di Sonnet 5, e otto dei dodici errori principali vengono dalla trave, dove mettere da parte una lettura contraddittoria è una correzione naturale. I modelli erano le versioni disponibili tra il 28 settembre e il 1° ottobre. Il preprint non è passato da una revisione paritaria e non indaga perché i modelli si comportino così. Un ingegnere che legge tutta la risposta trova l’avvertimento; un programma che ne legge solo l’ultima riga no. In quelle undici risposte, la frase che dichiara il problema impossibile e la parola che lo dà per risolto stanno a poche righe di distanza.
Language models can notice an impossible engineering problem yet still report it as solved — Yang e Wang
Preprint arXiv 2610.06668 (5 ottobre 2026, Santa Clara University): 14 modelli, 30 coppie di problemi di meccanica in cui una delle due versioni è resa impossibile da un solo dato cambiato; soluzioni verificate con due metodi indipendenti e, per tre famiglie, con OpenSees. Letto per intero il 10 ottobre: Figura 1, Tabella supplementare 12, Tabella 3 e testi delle richieste. Verifica diretta: la trave della Figura 1 ricalcolata con un modello a elementi finiti (estremità sinistra sollevata di 3,49 mm, 2,15 m staccati da terra), in accordo con l’articolo. Non verificati: gli altri problemi e le risposte originali (non ancora pubblicati), la classificazione degli errori fatta con l’AI, le ragioni del comportamento dei modelli. Non sottoposto a revisione paritaria.
Leggi il preprint di Yang e Wang Apri il PDF completo, con la Figura 1 e i testi delle richieste Scopri OpenSees, il simulatore usato per la verifica esterna